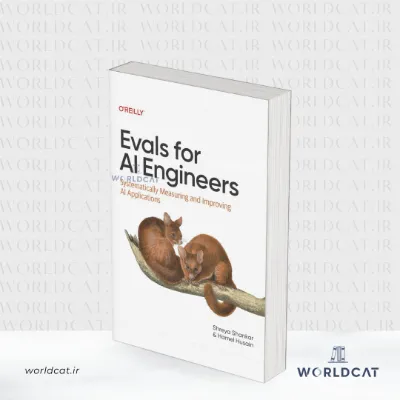
کتاب Evals for AI Engineers با عنوان کامل Evals for AI Engineers: Systematically Measuring and Improving AI Applications راهنمایی کاربردی برای تیمهایی است که اپلیکیشنهای هوش مصنوعی، بهویژه سیستمهای مبتنی بر مدلهای زبانی بزرگ (LLM)، میسازند و میخواهند کیفیت آنها را بهجای حدس و گمان با روشی نظاممند بسنجند و بهبود دهند. نویسندگان این کتاب، شریا شانکار و همل حسین، مهندسان هوش مصنوعیای هستند که در بیش از ۳۵ محصول هوش مصنوعی و پژوهشهای پیشرو تجربه کسب کردهاند و در این کتاب تکنیکهایی را آموزش میدهند که تیمها برای ساخت سیستمهای قابلاعتماد در محیط تولید واقعاً به آن نیاز دارند.
چرا ارزیابی (Evals) در توسعه اپلیکیشنهای هوش مصنوعی حیاتی است؟
خروجی مدلهای زبانی غیرقطعی است؛ یک تغییر کوچک در پرامپت، مدل یا داده میتواند رفتار سیستم را به شکلی پیشبینینشده تغییر دهد. بسیاری از تیمها کیفیت محصول را با چند آزمایش دستی و برداشت شخصی میسنجند، روشی که در مقیاس بزرگ شکست میخورد. کتاب Evals for AI Engineers نشان میدهد چگونه ارزیابی را به بخشی پیوسته از چرخه توسعه تبدیل کنید تا تصمیمها بر پایه داده گرفته شوند.
از حدس و گمان تا اندازهگیری نظاممند
هسته اصلی کتاب، جایگزینی «حس خوب داشتن نسبت به خروجی» با فرایندی قابل تکرار و قابل اندازهگیری است؛ فرایندی که همراه با رشد محصول تکامل مییابد و به تیم کمک میکند بدانند هر تغییر دقیقاً چه اثری بر کیفیت داشته است.
کتاب Evals for AI Engineers برای چه کسانی نوشته شده است؟
این کتاب برای مهندسان نرمافزار، مدیران محصول فنی و رهبران فنی تیمها طراحی شده است؛ افرادی که مسئول ساخت، عرضه و نگهداری محصولات هوش مصنوعی هستند. رویکرد کتاب عملی و دستبهکار است و تمرکز آن بر روشهایی است که در پروژههای واقعی جواب دادهاند، نه صرفاً مباحث نظری.
مباحث کلیدی کتاب
یافتن و اولویتبندی خطاها با تحلیل خطا
نخستین گام در بهبود هر سیستم هوش مصنوعی، شناخت دقیق شکستهای آن است. کتاب روش تحلیل خطای نظاممند (Error Analysis) را آموزش میدهد و نشان میدهد چگونه با ساخت مجموعههای آزمون نماینده (Representative Test Sets)، الگوهای خطا را کشف و آنها را بر اساس اهمیت اولویتبندی کنید.
ساخت ارزیابیهای قابلاعتماد
نویسندگان ابزارهای متنوعی برای ارزیابی معرفی میکنند و کاربرد هرکدام را توضیح میدهند:
- بررسیهای مبتنی بر کد: آزمونهای قطعی و ارزان برای قواعد مشخص مانند قالب خروجی.
- داور مدل زبانی (LLM-as-a-Judge): استفاده از یک مدل زبانی برای قضاوت درباره کیفیت خروجیها و روش اعتبارسنجی این داوران.
- بازخورد انسانی: بهرهگیری از قضاوت متخصصان بهعنوان مرجع اصلی کیفیت.
- داده مصنوعی (Synthetic Data): تولید داده آزمون برای پوشش سناریوهایی که هنوز در داده واقعی دیده نشدهاند.
بهبود سیستمهای در حال تولید در طول زمان
ارزیابی با عرضه محصول تمام نمیشود. کتاب نحوه پایش پسرفتها (Regressions) در محیط تولید و ایجاد توازن میان سه عامل کیفیت، تأخیر (Latency) و هزینه را شرح میدهد تا سیستم شما در طول زمان بهتر و بهینهتر شود.
درباره نویسندگان کتاب Evals for AI Engineers
شریا شانکار و همل حسین از چهرههای شناختهشده در حوزه ارزیابی سیستمهای مبتنی بر LLM هستند. تجربه آنها در کار با دهها محصول هوش مصنوعی و فعالیت پژوهشی باعث شده کتاب ترکیبی متعادل از دقت علمی و تجربه عملی باشد.
نتیجهگیری
اگر در حال ساخت محصولی مبتنی بر هوش مصنوعی هستید و میخواهید با اطمینان بدانید سیستمتان چقدر خوب کار میکند، کتاب Evals for AI Engineers منبعی ارزشمند است. این کتاب چارچوبی عملی برای تحلیل خطا، طراحی ارزیابیهای معتبر و بهبود مستمر کیفیت در اختیارتان میگذارد و کمک میکند بهجای حدس زدن، با داده تصمیم بگیرید. نسخه این کتاب را میتوانید از ورلدکت تهیه کنید.














هنوز بررسیای ثبت نشده است.