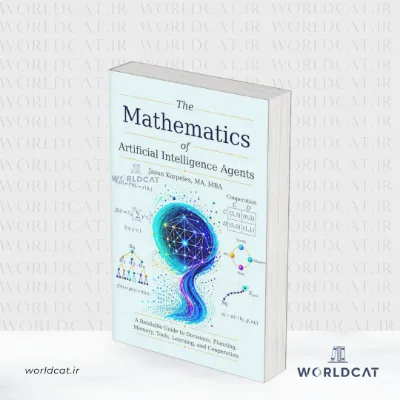
کتاب The Mathematics of Artificial Intelligence Agents نوشتهٔ جیسون کارپلس (Jason Karpeles) دنبالهٔ کتاب ریاضیات مدلهای زبانی همین نویسنده است. این کتاب بهجای خودِ مدل، سامانهای را بررسی میکند که دور مدل ساخته میشود: حلقهها، حافظه، ابزار، مجوزها و تصمیمها. کتاب در ۲۷ فصل و شش بخش نشان میدهد چنین عاملی با ریاضیات تصمیم، برنامهریزی، یادگیری، نظریهٔ بازیها و بهینهسازی مقید چگونه توصیف و سنجیده میشود و در کجا باید کنترل را به انسان برگرداند.
یک مدل زبانی، در سادهترین توصیف، توزیعی از احتمال است: زمینهای به آن میدهید و نشان میدهد چه چیزی محتمل است بعد بیاید. عامل هوش مصنوعی کارهای بیشتری میکند: سند بازیابی میکند، ابزار صدا میزند، شکستهای اجراهای قبلی را ثبت میکند و گاهی چون مجوز کار را ندارد از انجام آن خودداری میکند. اینها کارهای مدل نیستند؛ کارهای سامانهایاند که دور مدل ساخته شده است.
کتاب جیسون کارپلس دربارهٔ همین سامانه است. اگر ریاضیات خودِ مدلها را از همین نویسنده خواندهاید، کتاب The Mathematics of Large Language Models آن مسیر را باز کرده است و کتابی که در این صفحه معرفی میکنیم مرحلهٔ بعد را برمیدارد: از مدل به سامانه. خود نویسنده در پیشگفتار میگوید این کتاب دربارهٔ چیزی است که وقتی دیگر فقط مدل را مطالعه نمیکنیم و سراغ آنچه دور مدل ساخته شده میرویم پیدا میشود.
کتاب در یک نگاه
| عنوان کامل | The Mathematics of Artificial Intelligence Agents: A Readable Guide to Decisions, Planning, Memory, Tools, Learning, and Cooperation |
| نویسنده | جیسون کارپلس (Jason Karpeles، MA، MBA — طبق صفحهٔ عنوان کتاب) |
| سال و ویرایش | ۲۰۲۶، First Edition؛ طبق معرفی ناشر در بهروزرسانی اکتبر ۲۰۲۶ فهرست موضوعی پیوندی (بیش از ۲٬۰۰۰ مدخل) و مکمل کتاب افزوده شده است |
| ساختار | شش بخش، ۲۷ فصل و یک میانپرده؛ همراه با راهنمای نمادها، کارگاه ریاضی، فهرست منابع و فهرست موضوعی؛ فایل بیش از هزار صفحه دارد |
| مثال تکرارشونده | یک کنترلر انتشار سند که باید تصمیم بگیرد شواهد برای انتشار کافی است یا نه |
| منابع | ۶۵ ارجاع پژوهشی و یادداشت منبع برای هر فصل |
| مکمل | ۲۹ نوتبوک، ۲۸ مهارت برای دستیارهای هوش مصنوعی و کارگاه ریاضی؛ رایگان در گیتهاب |
| سطح | فنی؛ برای خوانندهای که میداند مدل زبانی چه میکند |
پرسشی که این کتاب را ساخته است
پرسش پیشگفتار ساده است: وقتی چیزی را دور مدل میسازیم، آیا عامل حاصل فراتر از خودِ مدل هم ماهیتی ریاضی دارد؟ نویسنده میگوید پاسخ را مثبت میداند، اما میخواهد این پاسخ دفاعپذیر باشد و شعار نباشد. به نظر او بخش بزرگی از نوشتهها دربارهٔ عاملها یک گام را جا میاندازند: میان آنچه به یک سامانه گفته میشود و آنچه واقعاً میتوان نشان داد انجام میدهد. روش او شبیه رفتار یک فیزیکدان با یک سامانه است: مؤلفهها را نام ببر، پیوندهای میان آنها را نام ببر، کمیت قابلمشاهده را مشخص کن و بگو چه چیزی باید غلط باشد تا ادعای تو شکست بخورد.
چهار شکست که از مدل بهتنهایی دیده نمیشوند
- مجوزی که وجود ندارد.
- بازیابی پاراگراف اشتباه.
- زنجیرهای از گامهای تقریباً امن که با هم یک اجرای شکستخورده میسازند.
- گذراندن یک ارزیابی در حالی که کارهای واقعیِ اندازهگیرینشده شکست میخورند.
کتاب میگوید مدل بهتر میتواند بعضی از این شکستها را سبکتر کند، اما نمیتواند مجوز اضافه کند، کاملبودن یک ارزیابی را ثابت کند یا رکوردی را بسازد که عامل هرگز ذخیره نکرده است. از همینجا فهرست کتاب شکل میگیرد.
چهار کاری که کتاب انجام نمیدهد
پیشگفتار صریحاً میگوید کتاب زمان پیدایش هوش عمومی مصنوعی را پیشبینی نمیکند و دربارهٔ معنادار بودن این اصطلاح بحث نمیکند. برای عامل حالت ذهنی قائل نمیشود؛ هر جا «میداند» یا «میخواهد» مینویسد، منظور یک شیء ریاضی تعریفشده است. فرمولی نمیآورد که در یک استدلال به کار نیامده باشد. و وانمود نمیکند حوزه تثبیتشده است. چند فصل آزمایشهایی را پیشنهاد میکنند که خواننده میتواند بازبینی یا تکرار کند.
چهار نوع جمله: اثباتشده، اندازهگیریشده، برازششده، پیشنهادی
یکی از مهمترین عادتهایی که کتاب میآموزد، جدا کردن چهار نوع ادعاست. قضیه تا جایی معتبر است که فرضهایش برقرار باشند. اندازهگیری فقط دربارهٔ سامانهٔ آزمایششده و پروتکل همان آزمایش معتبر است. منحنی برازششده خلاصهٔ دادهها تحت یک شکل تابعی است و برونیابیاش اعتبارسنجی جدا میخواهد. پیشنهاد هنوز آزمایش نشده است. این چهار روی صفحه شبیه هماند و در دنیای واقعی معناهای بسیار متفاوتی دارند. مثالهای ساختگی هم در کتاب برچسب میخورند و عددشان هرگز بهجای اندازهگیری ارائه نمیشود.
شش بخش کتاب، شش پرسش
کتاب The Mathematics of Artificial Intelligence Agents شش بخش دارد و هر بخش به پرسشی پاسخ میدهد که سازندهٔ یک عامل دیر یا زود با آن روبهرو میشود. هر فصل با یک مسئلهٔ تاریخی یا یک مسئلهٔ پژوهشیِ گزارششده شروع میشود و بعد نخستین معادلهٔ فصل میآید. در پایان هر فصل بخشی به نام «What this does not settle» محدودهٔ ادعا را مشخص میکند.
بخش اول: رفتار تازه از کجا میآید؟
این بخش به تشخیص درست از غلط میپردازد: وقتی میشنویم «توانایی جدیدی پدید آمد»، کدام بخش از ماجرا تغییر کرده است؟ خود مدل، قاعدهٔ امتیازدهی، یا حلقهای که مدل را درون خود گرفته؟ نویسنده دو نتیجهٔ منفی را برجسته میکند: یک منحنی مشهور توانایی تا حدی ساختهٔ قاعدهٔ امتیازدهی بوده است، و یک مقایسهٔ مشهور میان دو مدل نمیتواند پرسش پیدایش توانایی را حل کند، چون اندازهگیریهای لازم هرگز انجام نشدهاند.
- فصل ۱ — When a Score Becomes a Skill: چگونه امتیاز «دقیقاً برابر» یک پرش ظاهری میسازد.
- فصل ۲ — How to Measure Emergence: سنجش همکاری دو مؤلفه با چهار شرایط تطبیقیافته.
- فصل ۳ — How to Predict Emergence: پیشبینی پیش از دیدن نتیجه و ثبت آن.
- فصل ۴ — The Path from Prediction to Action: گراف دسترسپذیری؛ یک مجوز میتواند یک مسیر را کاملاً حذف کند.
- فصل ۵ — What the Model Becomes Inside an Agent: مدل ثابت، سامانهٔ متغیر؛ قانون گذار مدل درون حلقه.
بخش دوم: چگونه انتخاب کنیم؟
پیشبینی پیامد یک عمل هنوز نمیگوید کدام عمل را برگزینیم. این بخش ارزش را وارد ماجرا میکند و سپس آینده را به تصمیم امروز میآورد. مثال تکرارشونده اینجا برای اولین بار کار میکند: انتشار فوری، درخواست شواهد بیشتر و ارجاع به انسان، هر کدام با قیمتی در یک جدول آموزشی.
- فصل ۶ — The Price of a Choice: مطلوبیت مورد انتظار و اینکه خودداری از عمل هم یک عمل است.
- فصل ۷ — The Equation That Looks Ahead: معادلهٔ بلمن؛ چرا تأییدی که همین حالا هزینه دارد میتواند برنده شود.
- فصل ۸ — Acting in the Dark: باور بهجای حالتِ دیدهنشده و قیمتگذاری نگاه کردن.
بخش سوم: چگونه برنامه بریزیم و یاد بگیریم؟
آیندهها بیش از آناند که همه را بررسی کنیم. این بخش نشان میدهد چطور با تخمین هزینهٔ باقیمانده جستوجو را هدایت کنیم، کارهای چندمرحلهای را واحد اقدام بدانیم، میان کاوش و بهرهبرداری تعادل بسازیم و از پیامدهای دیرهنگام یاد بگیریم.
- فصل ۹ — Searching the Future: جستوجوی A*، شرط پذیرفتنیبودن تخمین و هزینهٔ خودِ تخمین.
- فصل ۱۰ — Plans Within Plans: گزینهها (options) و مهارتهای قابلاستفادهٔ مجدد.
- فصل ۱۱ — The Mathematics of Curiosity: پشیمانی، شاخص خوشبینانه و ارزش صفرِ اطلاعاتی که تصمیم را تغییر نمیدهد.
- فصل ۱۲ — Credit for Consequences: یادگیری تفاضل زمانی؛ خطای پیشبینی با مسئولیت علّی یکی نیست.
- فصل ۱۳ — Learning to Choose: آموزش از مسیرها، گرادیان سیاست و جدا کردن پاداش اندازهگیریشده از موفقیت واقعی.
بخش چهارم: عامل چه چیزی را به یاد بسپارد و چگونه با دنیا تماس بگیرد؟
این بخش معماری را میگشاید: مدل درونیِ جهان تا کجا قابلاعتماد است، چه رکوردهایی را میتوان نگه داشت و به آنها تکیه کرد، چگونه از میان پاسخهای نامزد انتخاب کنیم، و وقتی پاسخ یک درخواست گم میشود یا دکمهای در رابط جابهجا میشود چه میشود. میانپردهٔ کتاب نشان میدهد وقتی در طرف مقابل یک تصمیمگیرندهٔ دیگر هست، همان تلاش مجدد میتواند پاسخ بعدی را عوض کند.
- فصل ۱۴ — Building a World Inside: مدل جهان، خطای یکگامی و افق قابلاعتماد.
- فصل ۱۵ — What an Agent Should Remember: پنج نقش حافظه، بازیابی تحت بودجه و فرق مجوز جاری با متنِ مشابهِ قدیمی.
- فصل ۱۶ — Thought as Search: پوشش نامزدها در برابر انتخابشدن؛ نامزد درست حاضر است ولی تحویل داده نمیشود.
- فصل ۱۷ — State and Consequence: اثر و گزارش اثر دو چیزند؛ idempotence و تصمیم تکرار درخواست.
- فصل ۱۸ — When an Action Has Coordinates: فرمان مختصاتی در برابر فرمان معنایی و تراکنشی در رابطهای گرافیکی.
- میانپرده — When State Crosses a Boundary: وقتی طرف مقابل هم حافظه دارد و تطبیق مییابد.
بخش پنجم: وقتی دیگران هم تصمیم میگیرند چه میشود؟
وقتی سیاست طرف مقابل وارد قانون گذار محیط میشود، ارزشها و مدلها و ضمانتهایی که تا اینجا ساخته شد دیگر مستقل از آن نیستند. این بخش سه پاسخ میدهد: چگونه این وابستگی را بسنجیم، پیامها چه چیزی را میتوانند و چه چیزی را نمیتوانند تضمین کنند، و قواعد نهادی چگونه رفتار مجموعه را میسازند.
- فصل ۱۹ — When Another Mind Becomes Part of the World: ماتریس بازی متقابل؛ امتیازی که با شریک آشنا خوب است و با غریبه نه.
- فصل ۲۰ — Messages, Beliefs, and Consensus: دانش مشترک و مسئلهٔ حملهٔ هماهنگ.
- فصل ۲۱ — Markets, Teams, and Institutions: پارادوکس Braess و قیمتگذاری بر پایهٔ هزینهٔ نهایی.
بخش ششم: چه زمانی میتوان اعتماد کرد؟
بخش پایانی از قدرتِ عمل به مجوز عمل میرسد. محدودیت جدا از امتیاز؛ دستورهایی که از محیط میآیند و نباید فرمان شوند؛ سنجش اینکه یک ارزیابی چه مقدار از توانایی را بیرون کشیده؛ بهبود عامل بدون اعتماد کورکورانه به بهبود؛ سقف مشروط توانایی؛ و محاسبهٔ اینکه چه زمانی تصمیم باید به انسان واگذار شود.
- فصل ۲۲ — Safe Enough to Act: قید در برابر جریمه، و محدودهٔ عملیاتی که مجوز را میسازد.
- فصل ۲۳ — When the Environment Gives Instructions: امنیت عامل و تزریق دستور؛ جدا کردن داده از فرمان.
- فصل ۲۴ — How Much Capability Have We Extracted?: قرارداد ارزیابی، بانک تطبیقیافته و مرز پایینی.
- فصل ۲۵ — Improving an Agent Without Trusting the Improvement: نسخهبندی رویه، نگهبان ثابت، کاناری و بازگشت.
- فصل ۲۶ — How Much More Could the System Become?: سقف مشروط پوشش و انتخاب؛ این سقف بیشینهٔ مدل نیست.
- فصل ۲۷ — The Mathematics of Delegation: واگذاری بهعنوان عملی با مقصد، مجوز، مهلت و راه جایگزین.
هفت عدد از کتاب که سبک آن را نشان میدهد
کتاب پر از محاسبهٔ دستی است. هفت نمونهٔ زیر نشان میدهد این محاسبهها چه شکلی دارند. ردیفهای ۳ و ۴ و ۵ نتایج پژوهشی گزارششدهاند؛ بقیه محاسبههای آموزشیاند و نتیجهٔ اندازهگیری یک سامانهٔ واقعی نیستند.
| # | مثال | عدد | فصل |
|---|---|---|---|
| ۱ | تابع بیستخطی؛ درستی هر خط ۹۰٪ در برابر ۹۹٪ | حدود یک از هشت در برابر چهار از پنج | ۱ |
| ۲ | افق نیمهموفقیت وقتی درستی هر گام ۹۵٪، ۹۹٪ و ۹۹٫۹٪ است | حدود ۱۴، ۶۹ و ۶۹۳ گام | ۵ |
| ۳ | مدل جهان؛ امتیاز در محیط مجازی در برابر محیط واقعی در دمای ۰٫۱۰ | ۲۰۸۶ در برابر ۱۹۳ (سیاست تصادفی: ۲۱۰) | ۱۴ |
| ۴ | مدل Codex-12B؛ یک تلاش در برابر صد تلاش | ۲۸٫۸۱٪ در برابر ۷۲٫۳۱٪ | ۲۶ |
| ۵ | Codex-S؛ انتخاب نامزد با میانگین لگاریتم احتمال در برابر آزمون واحد | ۴۴٫۵٪ در برابر ۷۷٫۵٪ | ۲۶ |
| ۶ | شبکهٔ Braess؛ تأخیر هر مسافر پیش از میانبر رایگان و پس از آن | ۱٫۵ و سپس ۲ | ۲۱ |
| ۷ | بازبینی با ظرفیت ۳ مورد در ساعت؛ واگذاری ۹۰٪ از ۴ وظیفهٔ ساعتی | ۳٫۶ ورودی در ساعت؛ صف ناپایدار | ۲۷ |
ردیف ۱ و ۲ یک ایده را نشان میدهند: نمای ریاضی. هر چه خطاهای کوچک یک مرحله با هم ضرب شوند، رشد کمی در قابلیت اطمینان هر گام میتواند افق کار را چندین برابر کند. ردیف ۳ نشان میدهد چرا امتیاز داخل یک مدل درونی را نمیتوان با نتیجهٔ دنیای واقعی یکی گرفت. ردیف ۴ و ۵ نشان میدهند چرا حضور پاسخ درست میان نامزدها با تحویل آن به کاربر یکی نیست.
یک مثال که در همهٔ بخشها زنده میماند: کنترلر انتشار سند
کتاب بیشتر بحثهایش را با یک مثال ساختگی روشن میکند: یک مدل زبانی باید پیشنویس یک گزارش حادثه را منتشر کند، با این قاعده که هیچ ادعای عمومی بدون شواهد پشتیبان عبور نکند. حافظه، ابزار، مجوز، مشاهده و بازبینی انسانی به ریاضیات یک زمین واقعی میدهند. این مثال نمایندهٔ یک محصول موجود نیست؛ عددهایش برای آموزشاند.
همان کنترلر در سه فصل مختلف
- در فصل ۶، سه عمل با ارزشگذاری آموزشی مقایسه میشوند: انتشار فوری (۸۵)، درخواست شواهد (۹۲) و ارجاع به انسان (۵۹٫۵).
- در فصل ۷، تأیید پنج واحد هزینه دارد اما ارزش آیندهٔ آن، ۹۲ را در برابر ۸۵ برنده میکند.
- در فصل ۲۳، یک گزاره بررسی میکند که سند، نسخه و گیرنده دقیقاً همانهایی باشند که تأیید جاری برایشان صادر شده است؛ تأییدِ قدیمیِ نسخهٔ قبل هیچ نسخهٔ جدیدی را نمیپوشاند.
پیگیری یک درخواست، از شواهد و مجوز تا اثر خارجی و واگذاری، در گذرِ نهایی کارگاه ریاضی کتاب هم آمده است. در این گذر یک درخواست از میان حافظه، شواهد، تأیید بودجه، مجوزهای درخواستشده و اثرهای احتمالی آن رد میشود.
کتاب چگونه خوانده میشود؟
کتاب برای هر معادلهٔ مهم دو توضیح میدهد. «What it does» میگوید معادله چرا وجود دارد و چه مسئلهای را حل میکند. «Reading the formula» نمادها را قدمبهقدم میخواند. بهاینترتیب خواننده میتواند معادله را کامل ببیند و در عین حال بفهمد چرا آنجاست.
سه مسیر مطالعه وجود دارد. مسیر روایی داستان آغاز هر فصل، توضیحهای ساده کنار معادلهها و جمعبندی پایان فصل را دنبال میکند. مسیر فنی اثباتها و مقایسههای عددی را میخواند، مثالها را بازسازی میکند و منابع را دنبال میکند. بیشتر خوانندگان مسیر ترکیبی را میروند. کتاب میگوید اگر فقط یک بخش را میخوانید، بخش اول را بخوانید، چون ابزارهایی را میسازد که بقیهٔ کتاب از آنها استفاده میکند.
| هدف شما | فصلهای پیشنهادی خود کتاب |
|---|---|
| ارزیابی عاملها و بنچمارکها | فصلهای ۱، ۲، ۲۴ و ۲۶ |
| قابلیت اطمینان سامانه | فصلهای ۴، ۵، ۱۴، ۱۶، ۱۷، ۱۸ و ۲۴ |
| ایمنی و واگذاری | فصلهای ۴، ۲۲، ۲۳ و ۲۷ |
مکمل رایگان و کارگاه ریاضی
کتاب The Mathematics of Artificial Intelligence Agents فقط یک متن نیست. در پایان آن کارگاه ریاضی با ۲۳ مسئله (۱۸ مسئله به تفکیک بخشها و ۵ مسئلهٔ بسط) و راهحلهای گامبهگام آمده است. مکمل کتاب هم برای هر فصل یک نوتبوک دارد، بهعلاوهٔ یک نوتبوک آشنایی و یک نوتبوک نهایی؛ در مجموع ۲۹ نوتبوک. نوتبوکهای ۱ تا ۵ محاسبههای بخش اول را اجرا میکنند و میتوانید عدد را عوض کنید و حرکت نتیجه را ببینید.
| بخش | محتوا | نیازمندی |
|---|---|---|
| کارگاه ریاضی | ۲۳ مسئله با راهحل و یک گذر کامل برای کنترلر انتشار سند | فقط کتاب و ماشینحساب |
| نوتبوکها | ۲۹ نوتبوک: یکی برای هر فصل، یک آشنایی و یک نهایی | پایتون ۳٫۱۱ یا بالاتر |
| پروبهای محلی | شبیهساز انتشار سند و کنسول انتشار برای دیدن اثر مختصات قدیمی | پایتون ۳٫۱۰ یا بالاتر؛ بدون اشتراک مدل یا حساب API |
| مهارتها | ۲۸ مهارت برای دستیارهای هوش مصنوعی: یکی برای هر فصل و یک مهارت اصلی | نصب در دستیار موردنظر |
کتاب میگوید آزمایشگاه مکمل رایگان در گیتهاب منتشر شده است. میتوانید محاسبههای اجراشده را بدون نصب پایتون هم از راهنمای آفلاین بخوانید. دو کد QR در صفحهٔ آخر کتاب به سایت مکمل و مخزن گیتهاب میرسند؛ سایت مکمل اصلاحیهها، مقالههای تکمیلی و خبر دسترسی به نسخهٔ صوتی را هم در خود دارد.
کتاب The Mathematics of Artificial Intelligence Agents برای چه کسی است؟
کتاب برای خوانندهٔ فنیِ کنجکاوی نوشته شده که میداند مدل زبانی چه کار میکند و میخواهد سامانهٔ ساختهشده دور آن را بفهمد. این کتاب مقدمهٔ اولیه بر هوش مصنوعی نیست. به احتمال، تابع، مجموع، لگاریتم و امید ریاضی برمیخورید؛ لازم نیست پیشتر یادگیری تقویتی، نظریهٔ اطلاعات یا نظریهٔ گراف بدانید، چون هر فصل مفاهیم خودش را معرفی میکند.
| خواننده | چه چیزی به دست میآورد |
|---|---|
| مهندس و سازندهٔ عامل | اشتقاقها و محاسبههای دقیق برای تصمیم، تکرار درخواست، مجوز و بازگشت |
| پژوهشگر ارزیابی و ایمنی | قرارداد ارزیابی، بانک تطبیقیافته، تفکیک ادعاها و مدل تهدید |
| دانشجوی هوش مصنوعی یا علوم داده | پلی میان نظریهٔ تصمیم، یادگیری تقویتی و سامانههای مبتنی بر مدل زبانی |
| مدیر محصول فنی | فهم اینکه چرا یک عامل در عمل شکست میخورد و کدام تصمیمها باید سنجیده شوند |
| خوانندهٔ کنجکاو | مسیر روایی، بدون درگیر شدن با همهٔ جزئیات محاسبه |
این کتاب و ریاضیات مدلهای زبانی بزرگ
این دو کتاب یک سؤال را از دو طرف میپرسند. ریاضیات مدلهای زبانی بزرگ دربارهٔ این است که خودِ مدل چگونه کار میکند. کتابی که در این صفحه معرفی کردیم دربارهٔ آن است که وقتی مدل درون حلقهای از حافظه، ابزار، مجوز و مشاهده قرار میگیرد چه چیزی عوض میشود. خواندن اولی پیششرط دومی نیست؛ ولی اگر هر دو را بخوانید، تصویر کاملتری از مدل و از سامانه میبینید.
پیش از خرید: انتظار درست
- کتاب فنی است و معادلهها را کوتاه نمیکند؛ ولی هر فرمول با توضیحی کنارش میآید.
- کتاب پیشبینی نمیکند هوش عمومی مصنوعی کی میرسد و از «ذهن» عامل حرف نمیزند.
- بسیاری از عددها آموزشیاند. کتاب هر جا نتیجهٔ گزارششدهٔ یک پژوهش است منبع آن را میآورد و آن را از مثال ساختگی جدا میکند.
- هر فصل با بخشی دربارهٔ حدود ادعا بسته میشود تا نتیجه بیش از شواهدش گسترده نشود.
- اگر تازه با هوش مصنوعی آشنا میشوید، از جای دیگری شروع کنید و بعد سراغ این کتاب بیایید.
جمعبندی
کتاب The Mathematics of Artificial Intelligence Agents برای کسی است که میخواهد بداند یک سامانهٔ هوش مصنوعی چگونه تصمیم میگیرد، برنامه میریزد، یاد میگیرد، با دیگران همکاری میکند، شکست میخورد و کنترل را پس میدهد، و میخواهد هر ادعا را با ریاضی بسنجد. ساختار ششبخشی، مثال تکرارشوندهٔ کنترلر انتشار سند، تفکیک اثباتشده از پیشنهادی، کارگاه ریاضی و مکمل رایگان آن را از یک مرور سطحی به مرجعی قابلکار تبدیل میکند. اگر پیشتر سراغ ریاضیات مدلها رفتهاید، ریاضیات مدلهای زبانی بزرگ و این کتاب همدیگر را کامل میکنند. فرمتهای موجود و قیمت را در بخش خرید بالای همین صفحه ببینید.
منبع اطلاعات و تهیهکننده
اطلاعات این صفحه از متن خود کتاب (پیشگفتار، «How to Read This Book»، فهرست مطالب، کارگاه ریاضی و بخش «Where to Go Next») و معرفی ناشر برای ویرایش اکتبر ۲۰۲۶ گرفته شده است. عددها یا از محاسبهٔ آموزشی کتاباند یا نتیجهٔ پژوهشهایی که کتاب به آنها ارجاع میدهد؛ جدول «هفت عدد» این تفکیک را نشان میدهد. فهرست منابع کتاب ۶۵ مورد دارد.
نویسنده: جیسون کارپلس (Jason Karpeles)، نویسندهٔ این کتاب و کتاب ریاضیات مدلهای زبانی بزرگ. مخزن مکمل در گیتهاب: KarpelesPublishing/math-ai-agents
تهیهکننده: تیم محتوای worldcat.ir | آخرین بروزرسانی: آبان ۱۴۰۵













هنوز بررسیای ثبت نشده است.