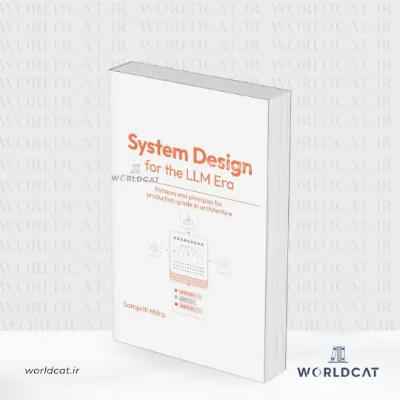
کتاب System Design for the LLM Era اثر Sampriti Mitra یک راهنمای معماری تولیدی برای سیستمهای LLM است که بهجای آموزش مدل، بر الگوهای عملیاتی، تابآوری، هزینه و مقیاسپذیری تمرکز دارد. این کتاب با چهار مطالعه موردی واقعی، شکاف میان طراحی سیستم کلاسیک و چالشهای غیرقطعی LLM را پر میکند و برای معماران با پیشنیاز طراحی سیستم توزیعشده نوشته شده است.
طراحی سیستم در عصر LLM با یک پارادوکس روبروست: از یک سو، اصول کلاسیک caching، load balancing و circuit breaker هنوز معتبرند؛ از سوی دیگر، ماهیت غیرقطعی، هزینه متغیر و تأخیر بالای LLMها این اصول را به چالش میکشند.
Sampriti Mitra در این کتاب تلاش میکند نشان دهد که چگونه میتوان LLM را بهعنوان یک مؤلفه معماری درک کرد، نه بهعنوان یک جعبه سیاه جادویی. کتاب در ۸ فصل، از مفاهیم پایه تا مطالعات موردی عمیق پیش میرود.
کتاب System Design for the LLM Era چه جایگاهی در بازار کتابهای معماری نرمافزار دارد؟
این کتاب در نقطه تلاقی دو حوزه نسبتاً جداگانه قرار میگیرد: طراحی سیستمهای توزیعشده کلاسیک و مهندسی عملیاتی LLM. جایگاه آن بهعنوان یک پل میان این دو حوزه تعریف میشود.
نویسنده در مقدمه کتاب هدف خود را اینگونه بیان میکند: «هدف کتاب نشان دادن نحوه یکپارچهسازی و عملیاتیسازی LLMها در معماریهای نرمافزاری مقیاسپذیر موجود است» (System Design for the LLM Era، Preface، ص. xxi).
Sampriti Mitra یک رهبر مهندسی نرمافزار مستقر در هند است. او دانشآموخته IIT BHU با بیش از هفت سال تجربه در طراحی و ساخت سیستمهای توزیعشده مقیاسپذیر است. سابقه حرفهای او شامل نقشهایی در Sumologic و Razorpay میشود. او خبرنامهای با نام Architecturally Speaking (https://architecturallyspeaking.substack.com) را اداره میکند که به تجزیه اصول طراحی سیستم اختصاص دارد (About the author، ص. iii).
| نام کتاب | نویسنده | تمرکز اصلی | مناسب برای | امتیاز کلی آمازون |
|---|---|---|---|---|
| System Design for the LLM Era | Sampriti Mitra | معماری تولیدی LLM | معماران با پیشنیاز طراحی سیستم | ۴.۴/۵ |
| Designing Data-Intensive Applications | Martin Kleppmann | اصول داده در سیستمهای توزیعشده | مهندسان داده و معماران | ۳.۸/۵ |
| AI Engineering | Chip Huyen | چرخه عمر مدلهای AI | مهندسان ML و داده | ۴.۶/۵ |
کتاب Mitra در مقایسه با DDIA، عمق فنی کمتری در اصول توزیعشده دارد اما شکاف LLM را پر میکند. در مقایسه با AI Engineering، تمرکز آن بر معماری تولیدی است نه چرخه عمر مدل.
تفاوت رویکرد این اثر با کتابهای کلاسیک طراحی سیستم
تفاوت اصلی در نوع چالشهایی است که کتاب به آنها میپردازد. کتابهای کلاسیک طراحی سیستم فرض میکنند سیستم قطعی است، در حالی که کتاب Mitra بر غیرقطعیبودن بهعنوان یک محدودیت بنیادین تمرکز دارد.
Mitra در فصل ۱ مینویسد:
ساخت با LLMها نیازمند تغییر بنیادین به مهندسی احتمالی (probabilistic engineering) است. همان ورودی x ممکن است y، y’ یا گاهی z تولید کند.
این نقلقول، سه پیامد معماری مستقیم دارد که در فصل ۲ کتاب بسط داده میشوند:
تست: در سیستمهای قطعی، assert(response) == "expected" کافی است. کتاب پیشنهاد میکند از Golden Datasets و LLM-as-a-Judge استفاده شود (فصل ۲، ص. ۴۵).
تابآوری: Circuit Breakers with Tiered Fallbacks در کتاب معرفی میشود تا درخواستها بهصورت خودکار به مدلهای پشتیبان هدایت شوند (فصل ۲، ص. ۳۵–۳۶).
هزینه: Model Router درخواستهای ساده را به مدلهای ارزانتر هدایت میکند، که در سیستمهای کلاسیک معادل ندارد (فصل ۲، ص. ۴۱).
مخاطب حرفهای در برابر مخاطب مقدماتی: کتاب برای کدام گروه نوشته شده است؟
کتاب برای مهندسان، معماران و رهبران فنی با پیشنیاز طراحی سیستم توزیعشده نوشته شده است. این یک کتاب مقدماتی طراحی سیستم یا یک کتاب آموزش LLM نیست.
نویسنده در Preface (ص. xxi) مینویسد:
کتابی درباره ساخت، آموزش یا تحقیق در مکانیک داخلی مدلهای AI/ML نیست، و نه یک پرایمر عمومی طراحی سیستم است.
آیا برای توسعهدهنده تازهکار مناسب است؟ خیر. کتاب فرض میکند خواننده با caching، microservices و circuit breaker آشناست.
آیا برای پژوهشگر ML مناسب است؟ خیر. کتاب به ریاضیات پشت ترنسفورمرها یا fine-tuning نمیپردازد.
و آیا برای معمار ارشد مناسب است؟ بله. کتاب فرض میکند خواننده میخواهد اصول کلاسیک را برای LLM اقتباس کند.
آیا این کتاب برای مهندسان و معماران امروز ارزش خواندن دارد؟
بله، برای مهندسان و معمارانی که در حال طراحی یا نگهداری سیستمهای تولیدی مبتنی بر LLM هستند. برای کسانی که به دنبال آموزش مدل یا اصول مقدماتی طراحی سیستم هستند، مناسب نیست.
چهار دلیل برای خواندن:
- پوشش شکاف معماری LLM: کتاب الگوهای GenAI Service، Circuit Breakers with Tiered Fallbacks و Model Router را معرفی میکند (فصل ۲، ص. ۳۲–۴۱).
- چهار مطالعه موردی عمیق: فصلهای ۳ تا ۶ هر کدام یک سیستم واقعی را از الزامات تا deep dive بررسی میکنند.
- تمرکز بر هزینه و تأخیر بهعنوان محدودیت معماری: کتاب این دو را نه بهعنوان بهینهسازی بعدی، بلکه بهعنوان تصمیمهای طراحی در نظر میگیرد (فصل ۲، ص. ۴۱).
- استناد به منابع واقعی: کتاب از وبلاگهای مهندسی Cursor، Duolingo، DoorDash و MongoDB استفاده میکند (References، ص. ۱۰۱، ۱۳۹، ۱۸۶، ۲۲۴).
سه دلیل برای نخواندن:
- عدم پوشش آموزش مدل: کتاب بهصراحت اعلام میکند که به مکانیک داخلی مدلها نمیپردازد (Preface، ص. xxi).
- وابستگی به اکوسیستم ابری: راهحلها به AWS، DynamoDB، Neptune و OpenSearch وابستهاند (فصل ۵ و ۶).
- ریسک کهنهشدن نمونهها: با سرعت تغییر مدلهای LLM، برخی نمونهها ممکن است بهزودی نیاز به بهروزرسانی داشته باشند.
اگر معمار یا مهندس ارشدی هستید که در حال طراحی سیستم تولیدی LLM است، این کتاب ارزش زمان شما را دارد.
نشانههایی که میگویند این کتاب برای تیم شما مناسب است
اگر تیم شما در حال ساخت سیستم تولیدی LLM است و با چالشهای تابآوری، هزینه و تأخیر دستوپنجه نرم میکند، این کتاب مناسب تیم شماست.
- تیم شما از LLM در تولید استفاده میکند یا قصد دارد استفاده کند.
- با هزینههای متغیر LLM مواجه هستید و به دنبال Model Router هستید (فصل ۲، ص. ۴۱).
- با تأخیر بالا مواجه هستید و به دنبال Hybrid Processing، Response Streaming و Caching Strategies هستید (فصل ۲، ص. ۳۶–۴۰).
- نگران قطعی ارائهدهنده LLM هستید و به Circuit Breakers with Tiered Fallbacks نیاز دارید (فصل ۲، ص. ۳۵–۳۶).
- با چالشهای RAG و GraphRAG مواجه هستید (فصل ۱، ص. ۱۹–۲۳ و فصل ۶، ص. ۱۹۰–۲۱۲).
اگر حداقل سه مورد از این چکلیست در تیم شما صدق میکند، کتاب Mitra یک منبع عملیاتی ارزشمند است.
زمانی که باید سراغ منابع دیگر بروید
اگر به دنبال آموزش مدل، ریاضیات پشت LLM، یا اصول مقدماتی طراحی سیستم هستید، باید سراغ منابع دیگری بروید.
کتاب Mitra دامنه خود را محدود میکند. در Preface (ص. xxi) صریحاً اعلام شده است که کتاب یک پرایمر طراحی سیستم یا یک منبع آموزش مدل نیست.
- آموزش مدل و ریاضیات ترنسفورمر: Speech and Language Processing (Jurafsky و Martin) یا Deep Learning (Goodfellow و همکاران).
- اصول مقدماتی طراحی سیستم: System Design Interview (Alex Xu) یا Designing Data-Intensive Applications (Martin Kleppmann).
- چرخه عمر مدل و MLOps: AI Engineering (Chip Huyen).
برای درک محدودیتهای دقیقتر کتاب، بخش «نقدهای منفی و محدودیتهای کتاب» در همین صفحه را ببینید.
مقایسه System Design for the LLM Era با کتابهای مشابه
کتاب Mitra در مقایسه با کتابهای مشابه، تمرکز منحصربهفردی بر معماری تولیدی LLM دارد، نه بر آموزش مدل یا اصول مقدماتی طراحی سیستم.
کتاب Mitra در مقایسه با DDIA، عمق فنی کمتری در اصول توزیعشده دارد اما شکاف LLM را پر میکند. در مقایسه با AI Engineering، تمرکز آن بر معماری تولیدی است نه چرخه عمر مدل.
تمرکز بر معماری تولیدی در برابر تمرکز بر مدلسازی
کتاب Mitra بر معماری تولیدی تمرکز دارد، نه بر مدلسازی. بهجای آموزش نحوه ساخت مدل، به نحوه ادغام مدل در یک سیستم تولیدی میپردازد.
در کتابهای مدلسازی، فصلهایی درباره معماری ترنسفورمر، توابع فعالسازی و fine-tuning وجود دارد. کتاب Mitra این موضوعات را پوشش نمیدهد.
در فصل ۳ (Case Study: Designing AI-Native IDEs)، کتاب بهجای توضیح نحوه آموزش یک مدل برای تکمیل کد، به معماری سیستم میپردازد: چگونه از gRPC برای استریم دوطرفه استفاده شود، چگونه Merkle Tree برای همگامسازی تغییرات به کار رود، و چگونه latency زیر ۲۰۰ms حفظ شود (فصل ۳، ص. ۶۶–۷۲).
این تمرکز، نقطه قوت کتاب برای معماران و نقطه ضعف آن برای پژوهشگران ML است.
پوشش مسائل عملیاتی در مقایسه با راهنماهای پرامپتنویسی
کتاب Mitra به مسائل عملیاتی مانند تابآوری، هزینه، تأخیر و مقیاسپذیری میپردازد، در حالی که راهنماهای پرامپتنویسی عمدتاً بر بهینهسازی پرامپت تمرکز دارند.
کتاب Mitra تکنیکهای پرامپتنویسی مانند Chain-of-Thought و Few-Shot Prompting را در فصل ۱ (ص. ۱۱–۱۲) بهصورت خلاصه معرفی میکند، اما تمرکز اصلی آن بر مسائل عملیاتی است.
در فصل ۵ (Case Study: AI-Powered Search for E-Commerce Platforms)، کتاب بهجای تمرکز بر پرامپتنویسی برای جستجو، به معماری سیستم میپردازد: کش چندلایه (L1، L2، warm tier)، ترکیب offline pipeline و near-real-time path، و حفظ latency زیر ۱ ثانیه (فصل ۵، ص. ۱۶۸–۱۷۵).
در سیستمهای تولیدی، پرامپتنویسی تنها یکی از عوامل موفقیت است و معماری سیستم نقش تعیینکنندهتری دارد.
نقدهای منفی و محدودیتهای کتاب: چه چیزی را نباید انتظار داشته باشید؟
کتاب Mitra سه محدودیت مشخص دارد: عمق فنی کم در آموزش مدل، وابستگی به اکوسیستم ابری، و ریسک کهنهشدن نمونهها.
نقد اول: کتاب بهصراحت اعلام میکند که «کتابی درباره ساخت، آموزش یا تحقیق در مکانیک داخلی مدلهای AI/ML نیست» (Preface، ص. xxi). اگر به دنبال درک ریاضیات پشت ترنسفورمرها هستید، این کتاب مناسب شما نیست.
نقد دوم: بسیاری از راهحلها به سرویسهای ابری خاص وابستهاند. فصل ۵ به DynamoDB، OpenSearch و Turbopuffer اشاره میکند (فصل ۵، ص. ۱۶۲–۱۶۵) و فصل ۶ به Neptune و S3 (فصل ۶، ص. ۲۰۷–۲۱۲). اگر تیم شما از اکوسیستم دیگری استفاده میکند، نیاز به اقتباس خواهید داشت.
سوم: با سرعت تغییر مدلهای LLM، برخی نمونههای کتاب ممکن است بهزودی نیاز به بهروزرسانی داشته باشند. کتاب به GPT-5، Claude 3 Opus و Gemini 2.5 اشاره میکند (فصل ۲، ص. ۳۵–۳۶).
این محدودیتها کتاب را بیارزش نمیکنند، اما آن را به یک منبع تخصصی، نه یک منبع جامع، تبدیل میکنند.
عمق فنی در حوزه آموزش و تنظیم دقیق مدلها
کتاب Mitra عمق فنی کمی در حوزه آموزش و تنظیم دقیق مدلها دارد. این موضوع بهصراحت در Preface کتاب اعلام شده است.
هیچ فصلی از کتاب به آموزش مدل، معماری ترنسفورمر یا روشهای fine-tuning اختصاص ندارد. فصل ۱ (Atomic Units of LLM Systems) مفاهیمی مانند pre-training و fine-tuning را بهصورت خلاصه معرفی میکند (فصل ۱، ص. ۷–۸)، اما به عمق ریاضیات یا پیادهسازی نمیرود.
برای معمارانی که به دنبال درک سطح بالا هستند، این کافی است. برای پژوهشگران ML که به دنبال پیادهسازی هستند، کافی نیست.
سرعت تغییر مدلها و ریسک کهنهشدن نمونهها
با توجه به سرعت تغییر مدلهای LLM، برخی نمونههای کتاب ممکن است در آینده نزدیک نیاز به بهروزرسانی داشته باشند. این یک ریسک ذاتی برای هر کتاب در حوزه LLM است.
کتاب Mitra در سال ۲۰۲۶ منتشر شده و به مدلهایی مانند GPT-5، Claude 3 Opus و Gemini 2.5 اشاره میکند (فصل ۲، ص. ۳۵–۳۶).
در فصل ۲، Circuit Breakers with Tiered Fallbacks با مدلهای Tier 1 (GPT-5)، Tier 2 (Claude 3 Haiku) و Tier 3 (Llama 3 8B) معرفی میشود (فصل ۲، ص. ۳۵–۳۶). اگر مدلهای جدیدتری منتشر شوند، این لایهبندی ممکن است نیاز به بهروزرسانی داشته باشد.
با این حال، اصول معماری (circuit breaker، caching، model router) معمولاً پایدارتر از مدلهای خاص هستند.
کتاب System Design for the LLM Era برای چه کسانی مناسب نیست؟
این کتاب برای پژوهشگران ML، توسعهدهندگان تازهکار، و کسانی که به دنبال اصول مقدماتی طراحی سیستم هستند، مناسب نیست.
کتاب Mitra یک منبع تخصصی است و برای همه مناسب نیست:
پژوهشگران ML: کتاب به مکانیک داخلی مدلها نمیپردازد (Preface، ص. xxi).
توسعهدهندگان تازهکار: کتاب فرض میکند خواننده با اصول طراحی سیستم توزیعشده آشناست.
کسانی که به دنبال اصول مقدماتی طراحی سیستم هستند: کتابهایی مانند System Design Interview یا Designing Data-Intensive Applications برای این گروه مناسبترند.
این اثر برای کدام تیمها یک سرمایهگذاری زمانی است؟
این کتاب برای تیمهای مهندسی که در حال ساخت یا نگهداری سیستمهای تولیدی مبتنی بر LLM هستند، یک سرمایهگذاری زمانی ارزشمند است.
تیمهایی که مناسب هستند:
- در حال ساخت سیستم تولیدی LLM هستند.
- با چالشهای تابآوری، هزینه و تأخیر دستوپنجه نرم میکنند.
- به دنبال الگوهای عملیاتی برای ادغام LLM هستند.
- معمارانی که میخواهند LLM را بهعنوان یک مؤلفه معماری درک کنند.
تیمهایی که مناسب نیستند:
- به دنبال آموزش مدل یا ریاضیات پشت LLM هستند.
- تازه با طراحی سیستم آشنا شدهاند.
- به دنبال اصول مقدماتی طراحی سیستم هستند.
کتاب System Design for the LLM Era اثر Sampriti Mitra یک منبع تخصصی و عملیاتی برای معماران و مهندسان ارشد است که میخواهند LLM را در سیستمهای تولیدی خود ادغام کنند. چهار مطالعه موردی عمیق، کتاب را به یک منبع ارزشمند برای تیمهایی تبدیل میکند که در حال ساخت سیستمهای تولیدی LLM هستند. محدودیتهایی مانند عدم پوشش آموزش مدل و وابستگی به اکوسیستم ابری باید قبل از خرید در نظر گرفته شوند.
سوالات متداول
۱. آیا این کتاب برای توسعهدهندگان تازهکار مناسب است؟
خیر. کتاب فرض میکند خواننده با اصول طراحی سیستم توزیعشده آشناست.
۲. آیا این کتاب به آموزش مدل میپردازد؟
خیر. کتاب بهصراحت اعلام میکند که به مکانیک داخلی مدلها نمیپردازد (Preface، ص. xxi).
۳. آیا این کتاب بهروز است؟
کتاب در ژوئن ۲۰۲۶ منتشر شده و به مدلهایی مانند GPT-5 و Claude 3 اشاره میکند. با سرعت تغییر LLM، ممکن است برخی نمونهها نیاز به بهروزرسانی داشته باشند.
۴. آیا این کتاب برای تیمهای کوچک مناسب است؟
کتاب بر سیستمهای مقیاسپذیر متمرکز است. اگر تیم شما در مقیاس کوچک کار میکند، ممکن است برخی الگوها (مانند Circuit Breakers with Tiered Fallbacks) بیش از حد پیچیده باشند.
۵. آیا این کتاب به مسائل امنیتی میپردازد؟
بله. فصل ۲ (ص. ۴۶–۵۰) به Prompt Injection، Secure Output Handling و Excessive Agency میپردازد.







هنوز بررسیای ثبت نشده است.